RAID-5 以「單盤容錯、性能均衡、空間利用率高」廣泛用於中小型服務器。當陣列狀態變為「失效/降級/離線」時,修復策略取決於故障盤是否物理損壞。本文詳述兩種場景的標準化操作流程(以 Windows Server 磁盤管理為例,原理通用)。
場景一:非物理故障(線路鬆動/控制器故障/驅動掉線)— 重激活修復
現象: 磁盤管理中故障盤顯示「遺失/脱機/聯機(錯誤)」,但硬體指示燈正常,SMART 無報警。
- 物理排查: 重新插拔數據/電源線,更換插槽/背板,確認控制器日誌無硬體錯誤;
- 重激活: 右鍵故障盤 → 「重新激活磁盤」;
- 觀察同步: 盤狀態轉為「聯機」,RAID-5 卷進入「重新同步」(Resyncing),進度條推進;
- 驗收: 同步完成,所有卷顯示「狀態良好」,冗餘恢復。
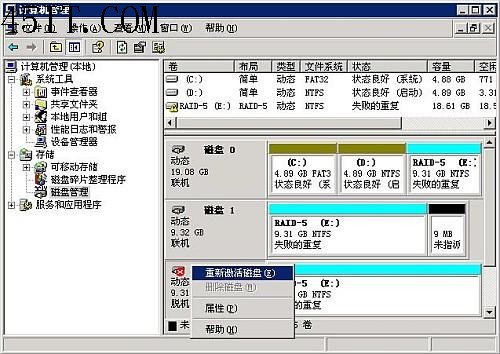
圖 1:執行「重新激活磁盤」命令
場景二:物理損壞(SMART 報警/異響/壞道/掉盤不識別)— 換盤重建
前提: 陣列仍處於「降級」而非「失效」(即僅 1 盤故障,RAID-5 容錯 1 盤)。若同時 2 盤故障,數據已不可逆損壞,需從備份恢復。
- 採購同款盤: 型號、容量、轉速、扇區大小(512n/4Kn)一致,建議同批次;
- 熱插拔更換: 拔出故障盤,插入新盤,控制器自動識別為「外來/未配置」;
- 初始化為動態磁盤: 磁盤管理 → 右鍵新盤 → 「轉換為動態磁盤」;
- 啟動重建: 右鍵故障盤(原盤符) → 「修復卷」 → 選中新盤 → 確定,開始重建;
- 監控進度: 重建期間 I/O 性能下降 30%-50%,避開業務高峰;大容量盤(≥4TB)重建可能耗時 12-48h;
- 移除故障盤引用: 重建完成後,右鍵故障盤(原盤符) → 「刪除磁盤」,清理配置元數據;
- 驗收: 陣列狀態「最佳/良好」,冗餘恢復,事件日誌無錯誤。
關鍵最佳實踐(生產環境必讀)
| 維度 | 建議 |
|---|
| 監控 | 控制器/作業系統/監控系統(Zabbix/Prometheus)三層監控:SMART 屬性、陣列狀態、重建進度、I/O 延遲 |
| 熱備份盤 | 機箱預留熱備份槽位,控制器配置 Global Hot Spare,故障瞬間自動重建,縮短風險窗口 |
| 備份先行 | 任何重建操作前,確認關鍵數據有可用、可恢復、離線的備份(3-2-1 原則) |
| 固件更新 | 定期更新 RAID 控制器固件、硬盤固件,修復已知兼容性/性能/數據完整性 Bug |
| 應急預案 | 文檔化「故障判斷→換盤→重建→驗收」SOP,定期演練,新人可獨立完成 |
常見誤區避坑
- ❌ 直接在 RAID 管理界面「刪除陣列」重建 — 數據全無;
- ❌ 重建期間強制關機/重啟 — 導致元數據不一致,陣列失效;
- ❌ 混用不同廠商/型號/扇區大小的盤 — 性能抖動、重建失敗、靜默數據損壞;
- ❌ 無備份直接重建 — 賭數據安全,後果自負。
結語: RAID-5 修復的核心邏輯是「判斷故障屬性 → 選擇對應流程 → 全程監控 → 驗收閉環」。非物理故障「重激活」秒級恢復;物理故障「換盤重建」小時級恢復。熱備份盤 + 多層監控 + 離線備份 才是生產環境的真正安全網。