Linux 核心雖穩定,但硬體錯誤、驅動缺陷、記憶體損壞仍可能觸發核心恐慌。kdump 利用 kexec 機制,在核心崩潰瞬間快速啟動一個預先載入的捕獲核心 (crash kernel),將崩潰時的記憶體鏡像 (vmcore) 轉儲至本地磁碟、NFS 或 SSH 遠端,供事後分析根因。
yum install -y kexec-tools crash kernel-debuginfo-$(uname -r)
# kernel-debuginfo 版本必須與執行中核心完全一致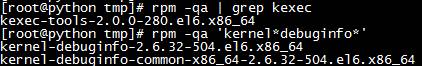
編輯 /etc/default/grub,在 GRUB_CMDLINE_LINUX 追加:
crashkernel=384M-:128M
# 表示實體記憶體 > 384MB 時保留 128MB 給 crash kernel
# 不建議使用 crashkernel=auto (RHEL 8 已棄用)
重建 grub 設定並重啟:
grub2-mkconfig -o /boot/grub2/grub.cfg
rebootpath /var/crash # 本地儲存路徑
core_collector makedumpfile -c --message-level 1 -d 31
# -c 壓縮, -d 31 排除零頁/快取頁/使用者頁/自由頁等非必要頁面
# 可改為 NFS/SSH 遠端:
# nfs 192.168.1.100:/export/crash
# ssh user@192.168.1.100systemctl enable kdump.service --now
systemctl status kdump.service
echo c > /proc/sysrq-trigger
# 系統會崩潰重啟,重啟後檢查 /var/crash/ 是否生成 vmcore 檔案

crash /usr/lib/debug/lib/modules/$(uname -r)/vmlinux /var/crash/127.0.0.1-2023-10-01-10:00/vmcore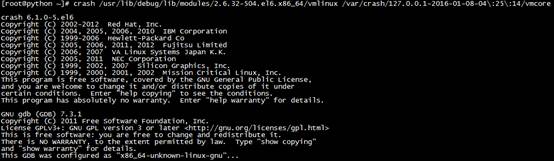
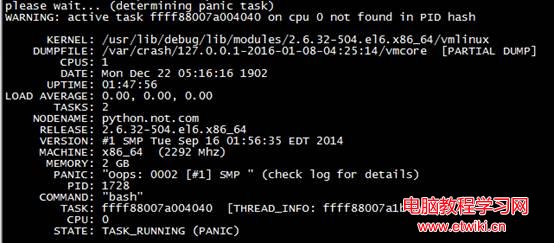
| 欄位 | 含義 | 分析價值 |
|---|---|---|
| PANIC | 崩潰類型: SysRq / Oops / Panic | Panic 為嚴重不可恢復錯誤 |
| PID / COMMAND | 觸發崩潰的進程號與名稱 | 鎖定嫌疑進程 |
| CPU | 崩潰發生的 CPU 核心 | 排查 CPU 親和性/硬體問題 |
| STATE | 進程狀態 (R/D/S/Z 等) | D 狀態暗示 I/O 等待 |
| 指令 | 用途 |
|---|---|
bt | 顯示當前執行緒呼叫堆疊 (backtrace) |
foreach bt | 顯示所有執行緒堆疊 |
log | 列印核心訊息緩衝區 (dmesg 內容) |
ps | 列出崩潰瞬間所有進程狀態 (> 表示活躍) |
files | 顯示當前進程打開的檔案描述符 |
vm | 顯示虛擬記憶體區域 (VMA) 資訊 |
mount | 顯示掛載點資訊 |
net | 簡易網路狀態 |
help / man | 查看指令說明 |
q / exit | 離開 crash |
crash> bt
PID: 1728  TASK: ffff8800...  CPU: 2  COMMAND: "bash"
 #0 [ffff8800...] machine_kexec at ffffffff8103...
 #1 [ffff8800...] __crash_kexec at ffffffff810...
 #2 [ffff8800...] panic at ffffffff815...
 #3 [ffff8800...] sysrq_handle_crash+0x16 at ffffffff81...
 #4 [ffff8800...] __handle_sysrq at ffffffff81...
 #5 [ffff8800...] write_sysrq_trigger at ffffffff81...
 #6 [ffff8800...] proc_reg_write at ffffffff81...
 #7 [ffff8800...] vfs_write at ffffffff81...
 #8 [ffff8800...] ksys_write at ffffffff81...
 #9 [ffff8800...] __x64_sys_write at ffffffff81...
#10 [ffff8800...] do_syscall_64 at ffffffff81...
#11 [ffff8800...] entry_SYSCALL_64_after_hwframe at ffffffff81...
RIP: 00007f...  RSP: 00007f...  RFLAGS: 00000246
RAX: 0000000000000001  RBX: 0000000000000000  RCX: 0000000000000000
...
[exception RIP: sysrq_handle_crash+22]  ← 核心函式 sysrq_handle_crash 偏移 22 處觸發例外
CS: 0010 (CPL=0 核心模式)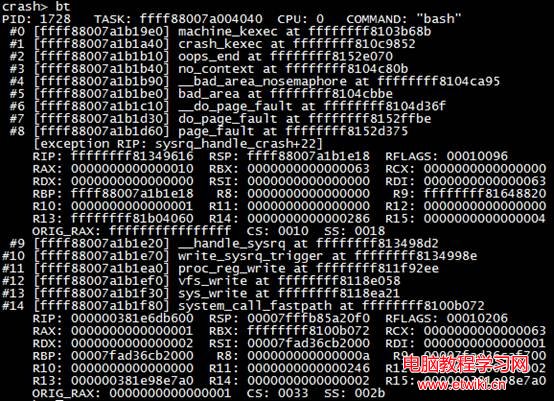
堆疊顯示透過 /proc/sysrq-trigger 手動觸發崩潰 (測試用)。實際生產崩潰會顯示驅動函式、記憶體管理路徑等關鍵線索。
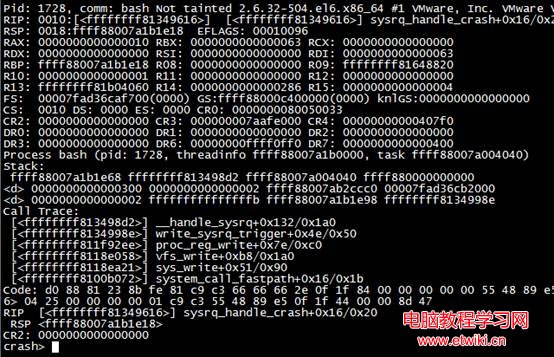 核心會印出
Call Trace 與 RIP,配合 bt 交叉驗證。

swapper (PID 0) 為每核心一個的排程器進程;崩潰進程 bash (PID 1728) 標記為活躍。
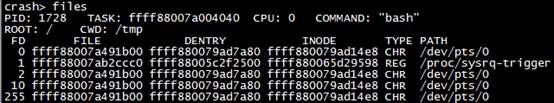 可見觸發崩潰前操作
/proc/sysrq-trigger。
深入分析需結合核心原始碼、addr2line 解析位址、git bisect 定位引入缺陷的提交。建立完整 kdump + crash 分析流程,是提升 Linux 系統可靠性的關鍵環節。