Sphinx(SQL Phrase Index)是高性能全文搜索引擎,支持 MySQL/PostgreSQL 數據源、增量索引、分布式搜索、多語言分詞(含中文),廣泛用於電商搜索、日志分析、CMS 站內搜。本文記錄在 CentOS 7 上從源碼編譯安裝、配置索引源、構建索引、PHP API 調用的全流程。
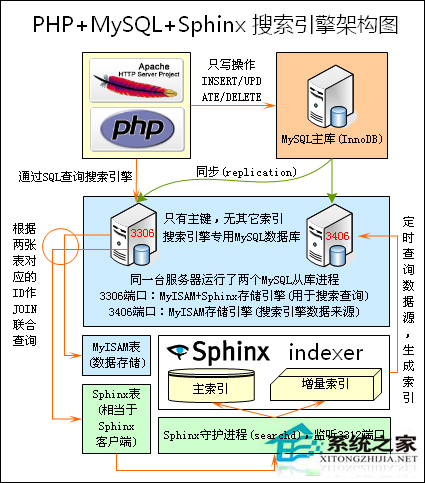
# 1. 安裝編譯依賴
yum install -y gcc gcc-c++ make automake autoconf libtool \
    mysql-devel postgresql-devel libstemmer-devel \
    libxml2-devel libxslt-devel icu libicu-devel

# 2. 下載源碼 (當前穩定版 3.6.0,或 4.x beta)
wget https://sphinxsearch.com/files/sphinx-3.6.0.tar.gz
tar -xzf sphinx-3.6.0.tar.gz
cd sphinx-3.6.0

# 3. 配置編譯選項
./configure --prefix=/usr/local/sphinx \
    --with-mysql \
    --with-pgsql \
    --with-stemmer \
    --with-libstemmer \
    --with-icu \
    --with-syslog

# 4. 編譯安裝
make -j$(nproc)
make install

# 5. 驗證
/usr/local/sphinx/bin/indexer --version
/usr/local/sphinx/bin/searchd --version
/usr/local/sphinx/etc/sphinx.conf# 數據源:MySQL
source src_articles
{
type = mysql
sql_host = 127.0.0.1
sql_user = sphinx_user
sql_pass = secret
sql_db = cms
sql_port = 3306
sql_query_pre = SET NAMES utf8mb4
sql_query = \
SELECT id, title, content, category_id, created_at \
FROM articles \
WHERE status=1 AND id>=$start AND id<=$end
sql_query_range = SELECT MIN(id), MAX(id) FROM articles WHERE status=1
sql_range_step = 10000
sql_attr_uint = category_id
sql_attr_timestamp = created_at
sql_field_string = title
sql_field_string = content
}
# 增量索引源(可選)
source src_articles_delta : src_articles
{
sql_query = \
SELECT id, title, content, category_id, created_at \
FROM articles \
WHERE status=1 AND id > (SELECT max_id FROM sphinx_counter WHERE counter_name='articles')
sql_query_range =
}
# 索引定義
index articles
{
source = src_articles
path = /var/lib/sphinx/data/articles
docinfo = extern
mlock = 0
morphology = stem_enru, libstemmer_zh_CN
min_word_len = 1
min_prefix_len = 0
min_infix_len = 1
ngram_len = 1
ngram_chars = U+3000..U+2FA1F
html_strip = 1
charset_table = 0..9, A..Z->a..z, _, U+410..U+42F->U+430..U+44F, U+430..U+44F, U+3040..U+309F, U+30A0..U+30FF, U+FF00..U+FFEF, U+3000..U+303F, U+4E00..U+9FFF
}
index articles_delta : articles
{
source = src_articles_delta
path = /var/lib/sphinx/data/articles_delta
}
# 分布式索引(合併主+增量)
index articles_dist
{
type = distributed
local = articles
local = articles_delta
agent_connect_timeout = 1000
agent_query_timeout = 3000
}
# 索引器設置
indexer
{
mem_limit = 256M
}
# 搜索守護進程
searchd
{
listen = 9312
listen = 9306:mysql41
log = /var/log/sphinx/searchd.log
query_log = /var/log/sphinx/query.log
read_timeout = 5
max_children = 30
pid_file = /var/run/sphinx/searchd.pid
seamless_rotate = 1
preopen_indexes = 1
unlink_old = 1
workers = threads
binlog_path = /var/lib/sphinx/binlog
}
# 創建數據目錄
mkdir -p /var/lib/sphinx/data /var/log/sphinx /var/run/sphinx
chown -R sphinx:sphinx /var/lib/sphinx /var/log/sphinx /var/run/sphinx

# 全量索引
/usr/local/sphinx/bin/indexer --config /usr/local/sphinx/etc/sphinx.conf --all --rotate

# 增量索引 (配合 cron 每 5 分鐘)
/usr/local/sphinx/bin/indexer --config /usr/local/sphinx/etc/sphinx.conf articles_delta --rotate

# 合併增量到主索引 (每天凌晨)
/usr/local/sphinx/bin/indexer --config /usr/local/sphinx/etc/sphinx.conf --merge articles articles_delta --rotate

# 啟動 searchd
/usr/local/sphinx/bin/searchd --config /usr/local/sphinx/etc/sphinx.conf

# 設置開機自啟 (systemd)
cat > /etc/systemd/system/sphinx.service <<'EOF'
[Unit]
Description=Sphinx Search Daemon
After=network.target mysql.service

[Service]
Type=forking
ExecStart=/usr/local/sphinx/bin/searchd --config /usr/local/sphinx/etc/sphinx.conf
ExecReload=/bin/kill -HUP $MAINPID
PIDFile=/var/run/sphinx/searchd.pid
User=sphinx
Group=sphinx

[Install]
WantedBy=multi-user.target
EOF
systemctl daemon-reload
systemctl enable --now sphinx
require_once 'sphinxapi.php';

$cl = new SphinxClient();
$cl->SetServer('127.0.0.1', 9312);
$cl->SetConnectTimeout(1);
$cl->SetArrayResult(true);
$cl->SetMatchMode(SPH_MATCH_EXTENDED2);
$cl->SetRankingMode(SPH_RANK_PROXIMITY_BM25);
$cl->SetLimits(0, 20);

$res = $cl->Query('全文搜索 關鍵詞', 'articles_dist');
if ($res === false) {
    die('Search error: ' . $cl->GetLastError());
}
echo "Total: {$res['total']}, Time: {$res['time']}s\n";
foreach ($res['matches'] as $doc) {
    echo "ID: {$doc['id']}, Weight: {$doc['weight']}, Attrs: ";
    print_r($doc['attrs']);
}
ngram_len = 1、ngram_chars = U+3000..U+2FA1F,將中文按單字切分,無需詞典,適合通用搜索。--with-libstemmer,基於詞典分詞,精度較高但需維護詞典。sphinx-jieba、scws、mmseg,編譯為動態庫加載,效果最佳但部署較複雜。| 維度 | 建議 |
|---|---|
| 內存 | indexer.mem_limit 設為物理內存 30-50%,searchd.workers=threads 利用多核 |
| 磁盤 | 索引文件放 SSD/NVMe,mlock=1 鎖定內存(需權限) |
| 索引策略 | 主索引每日重建,增量索引每 5-15 分鐘,合併每日一次 |
| 查詢優化 | 使用 SetSelect 僅獲取所需屬性,SetFilter 替代 WHERE,避免 SELECT * |
| 分布式 | 分片按 ID 範圍/Hash,副本提供高可用,agent_* 超時防雪崩 |
| 現象 | 原因 | 解決 |
|---|---|---|
ERROR: index 'articles': sql_connect: Access denied | MySQL 用戶權限不足 | 授予 SELECT, LOCK TABLES 權限 |
| 中文搜不到 / 分詞錯誤 | charset_table 未覆蓋中文範圍、分詞器未生效 | 補全 U+4E00..U+9FFF,確認 morphology 配置 |
| searchd 啟動後秒退出 | 配置語法錯誤、端口衝突、權限不足 | searchd --config ... --console 前台調試 |
| 查詢超時 | 結果集過大、未設置 SetLimits | 客戶端設置 SetLimits(0, 1000),服務端 max_matches |
Sphinx 以「快、準、穩」著稱,配合合理的索引策略、中文分詞、分布式架構,能輕松支撐億級文檔的毫秒級全文搜索,是構建搜索服務的經典選擇。