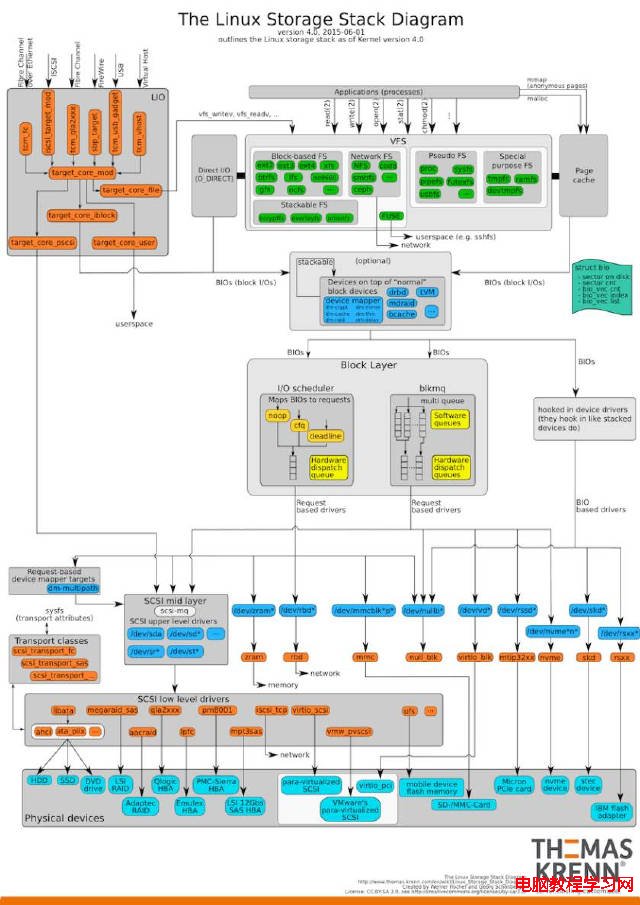
從 read()/write() 系統調用視角,IO 棧分七層:

機械硬盤順序讀寫吞吐高,隨機尋道延遲大。IO 調度器的目標:將隨機 IO 轉化為順序 IO,減少磁頭移動,提升整體吞吐與響應平衡。經典「電梯算法」思想:磁頭單向移動時,順便處理路過磁道的請求。
| 調度器 | 全稱 | 核心策略 | 適用場景 |
|---|---|---|---|
| noop | No Operation | 無排序,單純 FIFO 隊列,僅做基礎合並 | SSD、NVMe、虛擬化環境(由上層/硬體調度) |
| deadline | Deadline I/O Scheduler | 四隊列:讀/寫按扇區排序 + 超時隊列按時間排序,防餓死 | 數據庫、高 IOPS 負載、需低延遲保證場景 |
| cfq | Completely Fair Queuing | 按進程公平分配時間片,支持優先級、cgroup 隔離 | 桌面、通用服務器、多租戶公平共享 |
注意:noop 實質無調度;cfq 為內核長期默認;deadline 針對延遲敏感優化;舊有 anticipatory (as) 已移除。
公平對象是進程。衡量 IO 佔用用兩指標:帶寬(MB/s)與 IOPS(次/秒)。順序 IO 低 IOPS 高帶寬,隨機 IO 高 IOPS 低帶寬。cfq 認為分配相等的磁盤服務時間最公平,不管你佔用帶寬還是 IOPS。
cfq_data:調度器全局上下文cfq_group:對應 cgroup,維護 7 棵 service_tree(紅黑樹),按 vdisktime(虛擬磁盤時間)排序,時間少者優先調度SYNC(同步順序)、SYNC_NOIDLE(同步隨機)、ASYNC(異步寫)× RT/BE/IDLE 三優先級cfq_queue:每進程一個請求隊列,按服務時間紅黑樹排序

vdisktime 最小的 cgroup(紅黑樹)SSD 檢測到時禁用 idling(空轉等待),所有請求走 SYNC_NOIDLE。
/sys/block/sdX/queue/iosched/)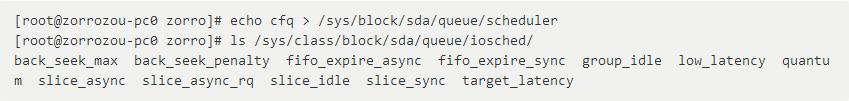
slice_idle:idling 時間(預設 8ms),SSD 設 0quantum:單次調度最大請求數(預設 8)group_idle:cgroup 級 idlinglow_latency:啟用低延遲模式(預設 1)數據庫(MySQL/PostgreSQL)、高併發寫入、對讀延遲敏感業務。echo deadline > /sys/block/sda/queue/scheduler 即時切換。
| 場景 | 推薦調度器 | 理由 |
|---|---|---|
| 機械硬盤桌面/通用服務器 | cfq | 進程公平,體驗均衡 |
| 數據庫主庫、高 IOPS 業務 | deadline | 低延遲、防餓死、順序合並 |
| SSD/NVMe、虛擬機客體 | noop / none (multi-queue) | 硬體/上層已優化,內核無需干預 |
| 高併發讀多寫少 | deadline | 讀請求優先級高 |
現代內核(5.0+)引入 blk-mq 多隊列框架,調度器架構大變,bfq (Budget Fair Queueing) 成為新默認選項,但上述原理仍具參考價值。