Beowulf 叢集概念源自 1994 年 NASA 專案:採用商用現貨硬體 (COTS)、標準以太網/高速互聯、Linux 作業系統、PVM/MPI 並行庫,將普通 PC 組裝為高性能並行計算機。相較傳統 MPP(大規模並行處理機),Beowulf 擁有極致性價比、無縫繼承 x86 軟硬體生態、快速吸納最新商用技術三大優勢。本文記錄一套 9 節點 Beowulf 叢集的完整構建過程:硬體拓撲優化、雙網卡綁定、Linux 服務配置、LAM/MPI 環境部署、MPI 程式設計範例與效能基準測試,為等離子體物理數值模擬等科研計算提供可複製參考。
| VLAN | 用途 | 流向 | 節點網卡 |
|---|---|---|---|
| LAN1 (VLAN 10) | 訊息接收網段 | 所有節點 → 交換機 | eth0 (僅接收) |
| LAN2 (VLAN 20) | 訊息發送網段 | 交換機 → 所有節點 | eth1 (僅發送) |
| LAN3 (VLAN 30) | 管理/外聯網段 | 遠程登入、外部存取 | 共用管理 IP |
設計精髓:雙網卡分離收發流量,消除單網卡半雙工衝突,有效雙倍頻寬;管理流量完全隔離,不干擾運算通訊。交換機配置 Port-based VLAN + 流控開啟,確保低延遲、無丟包。
| 服務 | 部署範圍 | 配置要點 | |
|---|---|---|---|
| rlogin / rsh | 8 計算節點 | RH7.1 預設關閉,需手動配置 /etc/hosts.equiv、~/.rhosts、/etc/pam.d/rsh 等,建立節點間無密碼信任 | |
| NFS | 服務節點 (Server) + 所有計算節點 | 服務節點匯出 /home、/usr/local;計算節點掛載,實現統一用戶環境與應用分發 | |
| FTP / Telnet | 所有節點 | 檔案傳輸與備用遠程登入 |
| 概念 | 說明 | C 語言句柄類型 |
|---|---|---|
| 通信子 | 一組可互相通訊的進程集合 | MPI_Comm |
| 秩序 | 進程在通信子中的唯一編號 (從 0 開始) | int |
| 資料類型 | MPI 定義的可移植類型 (MPI_INT, MPI_DOUBLE...) | MPI_Datatype |
| 請求句柄 | 非阻塞操作的標識 | MPI_Request |
| 狀態物件 | 接收操作返回的元數據 (來源、標籤、長度) | MPI_Status |
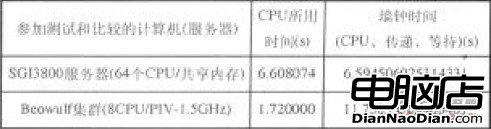
PC 叢集單節點串行計算速度 優於對比工作站/伺服器/品牌機,歸因於高主頻 P4 處理器與優化編譯器。
| 指標 | Beowulf 叢集 | SGI 3800 | 結論 |
|---|---|---|---|
| 程式執行時間 | 略低 / 持平 | 基準 | 性能相當 |
| 牆鐘時間 (含 CPU/通訊/等待) | 略低 / 持平 | 基準 | 通訊開銷可控 |
關鍵結論:基於 Fast Ethernet + 雙網卡綁定 + LAM/MPI 的 Beowulf 叢集,在 8 節點規模下並行效能已達商用 SMP 伺服器水平,且成本不足其 1/10。
本文展示的 9 節點 Beowulf 叢集,從硬體拓撲創新 (雙網卡 VLAN 分離收發)、系統工程細節 (雙網卡 bonding、rsh/NFS 信任域、LAM/MPI 部署)、到 MPI 程式設計規範與實測效能,構建了一套可複製、可擴展、高性價比的並行計算平台建設全流程。對於預算受限但有龐大計算需求的科研團隊、高校實驗室、中小企業研發部門,Beowulf + Linux + MPI 路線不失為通往高性能計算殿堂的最佳敲門磚。隨著萬兆以太網、RoCE、NVLink 等互聯技術下沉,新一代 Beowulf 叢集將持續重新定義「平民超算」的性能邊界。